推測加速機制 與 MTP(Multi-Token Prediction)和 DFlash 介紹
推測加速機制與 MTP(Multi-Token Prediction)介紹
推測加速機制(Speculative Decoding,也稱推測解碼、Speculative Sampling)與 MTP(Multi-Token Prediction,多 Token 預測)是目前加速大語言模型(LLM)推理的兩項重要技術。它們都針對傳統自回歸生成「一次只產生一個 token」的瓶頸,讓模型在一次前向傳播中處理多個 token,從而降低延遲、提高吞吐量。
兩者經常搭配使用:MTP 常作為推測加速中的「草稿產生機制」。
1. 推測加速機制(Speculative Decoding)
這是推理階段的優化技術,核心思想是「先由便宜的草稿模型快速猜,再由昂貴的目標模型一次驗證」。
基本流程:
- 使用一個小而快的草稿模型(draft model)預測接下來的 \(K\) 個 token。
- 把這 \(K\) 個候選 token 一次送進大型目標模型(target model)做平行驗證(一次前向傳播就能檢查整串)。
- 目標模型接受最長的一致前綴;遇到第一個不一致的地方就停止,並從那裡由目標模型自己繼續生成(或用拒絕採樣修正)。
關鍵優點是:輸出分佈與單純使用目標模型完全相同(數學上無損),不會降低生成品質。這是透過修改版的拒絕採樣(rejection sampling)達成的。
為什麼快?
大型模型的推理瓶頸常常是記憶體頻寬(讀取權重),而非純粹的計算。一次前向傳播處理 1 個 token 與處理 \(K\) 個 token 的時間差距不大。當草稿模型的接受率(acceptance rate)夠高時,就能以「一次大模型呼叫」換取多個 token,典型加速約 2–3 倍,進階變體(如 EAGLE、Medusa)可達更高。
常見變體:
- 外部小模型作為草稿(同家族模型配對效果通常最好)。
- 模型內部附加輕量頭(Medusa、EAGLE 等)。
- 提示中的 n-gram 查找、後綴匹配等無訓練方法。
- 樹狀驗證(token tree)以提高接受率。
這個技術最早由 Leviathan 等人(Google,2022/2023)與 Chen 等人(DeepMind,2023)幾乎同時提出,現在已廣泛支援於 vLLM、SGLang、TensorRT-LLM 等推理框架。
實務上效果最好的場景是:低並發、結構化輸出(程式碼、JSON、SQL)、可預測性高的任務。高並發或開放式創意生成時,接受率下降,收益會縮小。
可以參考這個網站的介紹:
https://blog.traversaal.ai/speculative-decoding-llm-inference-cost-production-benchmarks-2026/
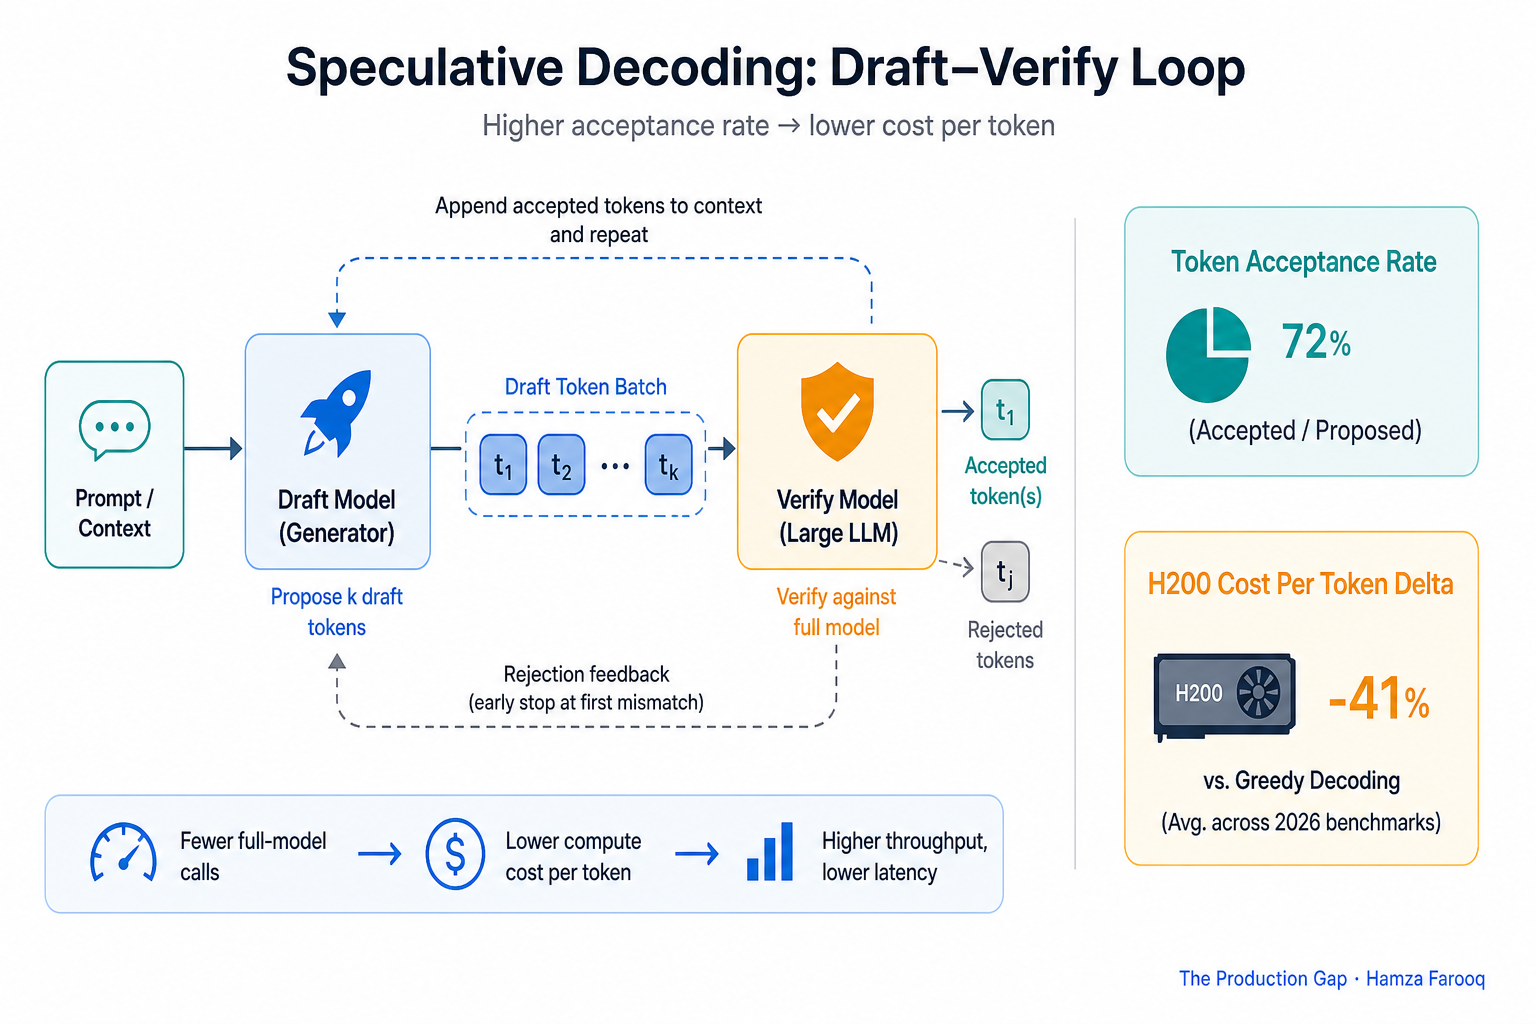
Speculative Decoding LLM Inference Cost: What Production Benchmarks Actually Show in 2026
2. MTP(Multi-Token Prediction)
MTP 主要是訓練階段的技術,也可以直接用於加速推理。
核心想法:
傳統訓練只讓模型預測下一個 token(next-token prediction)。MTP 則在每個位置同時預測未來多個 token(例如 \(t+1, t+2, t+3, t+4\)),使用多個輸出頭或額外的輕量模組,共享同一個模型主幹(trunk)。
原始論文是 Meta 的 Gloeckle 等人(2024)「Better & Faster Large Language Models via Multi-token Prediction」。他們使用多個獨立的輸出頭,在共享主幹上預測多個未來 token。
主要好處:
- 品質提升:提供更密集的學習信號,提高樣本效率。在生成任務(尤其是程式碼)上效果明顯。13B 模型在 HumanEval 上解決問題數提升約 12%,MBPP 提升約 17%。
- 推理加速:訓練時學到的多 token 預測能力,可在推理時直接一次產生多個 token,或作為推測解碼的草稿機制,最高可達約 3 倍加速(即使在較大 batch 下也有效)。
DeepSeek 的實作方式(較常見的現代做法):
DeepSeek-V3 採用序列式(sequential)MTP 模組,而非完全平行的獨立頭。每個 MTP 模組會結合主模型的隱藏狀態與下一個真實 token 的 embedding,經過線性投影與小型 Transformer block,再預測更遠的 token。這種設計保持因果關係,既可作為輔助訓練目標,也可在推理時拿來做推測解碼(不需要額外的獨立草稿模型)。
許多後續模型(DeepSeek-V3/V4 系列、部分 Qwen、GLM 等)都內建了 MTP 模組。
可以參考這個網站的介紹:
https://sebastianraschka.com/llm-architecture-gallery/mtp/
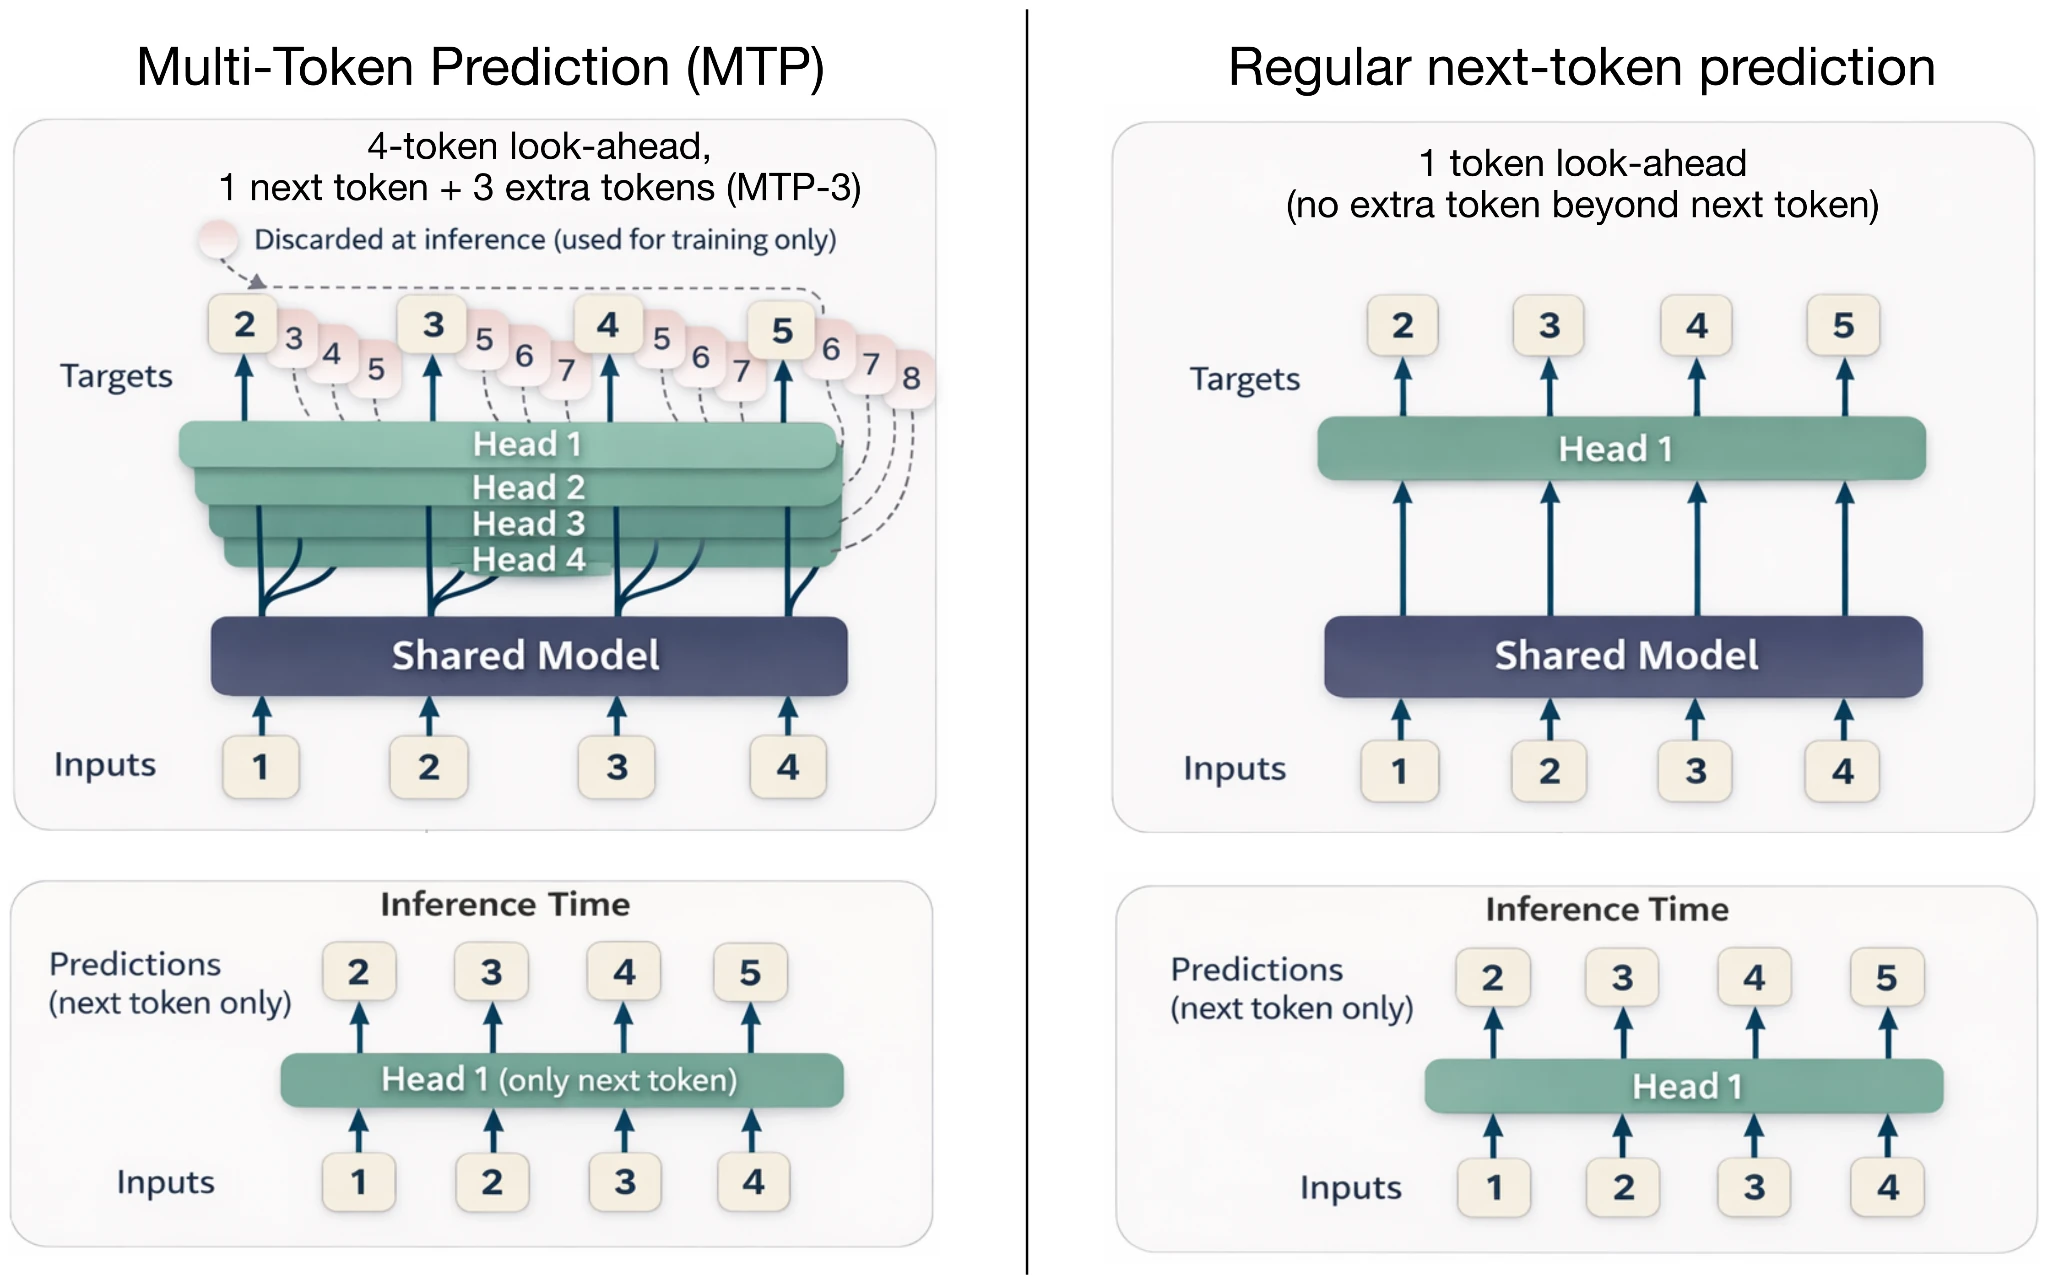
Multi-Token Prediction (MTP) | Sebastian Raschka, PhD
兩者的關係
| 面向 | 推測加速(Speculative Decoding) | MTP(Multi-Token Prediction) |
|---|---|---|
| 主要階段 | 推理時 | 訓練時(推理時可再利用) |
| 核心機制 | 草稿 + 平行驗證 | 多頭/多模組同時預測多個未來 token |
| 是否需要額外模型 | 通常需要草稿模型(或內部頭) | 內建於同一模型中 |
| 輸出保證 | 嚴格與目標模型相同 | 主頭保持原分佈,草稿頭用於加速 |
| 典型加速 | 2–3×(視接受率) | 可達約 2–3×(與推測搭配時) |
| 額外好處 | 純粹加速 | 同時提升模型品質(尤其生成任務) |
MTP 可以視為一種「內建的推測草稿機制」:模型在訓練時就學會預測多步,推理時把這些額外頭/模組拿來提案,再用主模型驗證,達到自我推測加速的效果,且不需額外載入另一個模型。
實務建議
- 如果只是想加速現有模型,直接使用推測解碼(搭配合適的草稿模型或框架內建的 EAGLE/Medusa)最直接。
- 如果是自己訓練模型,加入 MTP 目標通常有雙重好處:品質與速度。
- 效果高度依賴「接受率」。程式碼、結構化輸出、較可預測的任務收益最大;開放式長文本則較小。
- 現代推理框架(vLLM、SGLang、TensorRT-LLM 等)對這兩項技術都有良好支援,建議直接使用框架的官方實作。
這兩項技術是目前在不犧牲(或甚至提升)品質的前提下,最有效的推理加速手段之一,尤其適合延遲敏感的應用場景。
Meta Muse Glimmer 的 DFlash 技術與 MTP 的異同
什麼是 Muse Glimmer?
Muse Glimmer 是 Meta Superintelligence Labs 於 2026 年 8 月釋出的開源權重模型(Apache 2.0),約 30B 參數,從更大的 Muse Spark 蒸餾而來。它是多模態模型(含視覺感知編碼器),專為本地 agent 工作負載設計(工具呼叫、長任務、編碼代理等),可在單張消費級 GPU(約 24GB VRAM,透過量化)或 Apple Silicon 上離線執行,上下文長度支援 128K+。
Meta 在釋出時就內建了 DFlash 草稿模型(drafter),用來加速生成。
什麼是 DFlash?
DFlash(Block Diffusion for Flash Speculative Decoding)是由 UC San Diego Z Lab 提出的推測解碼技術(論文約 2026 年 2 月,arXiv:2602.06036)。它的核心是用一個輕量級的 block-diffusion 模型作為草稿器,而不是傳統的自回歸小模型。
運作方式:
- 草稿模型一次預測整塊 token(例如 block size = 16),在單次前向傳播中平行產生整個區塊。
- 它會從目標模型(target model)抽取多層的隱藏特徵,融合後注入到草稿模型的 KV cache 中,讓草稿品質更高。
- 目標模型再一次平行驗證整塊提案,接受正確的前綴(與標準推測解碼相同,輸出分佈與目標模型完全一致,屬於無損加速)。
- 因為草稿是「平行生成整塊」而非逐 token 自回歸,草稿成本幾乎不隨 block 長度線性增加,因此可以跑較長的推測長度,接受率也較高。
實際效果(官方與社群數據):
- 在 Muse Glimmer 上,Meta 報告 RTX 5090 從約 75 tok/s 提升到約 233 tok/s(約 3.1×);Apple M5 Max 約 1.8×。
- 一般模型上常達 3–6× 無損加速,並優於 EAGLE-3 等傳統方法。
- 後續有 DFlash 2(加入候選路徑選擇器與動態卷積等),進一步提高接受長度。
DFlash 已支援於 llama.cpp、SGLang、vLLM、Ollama(尤其是 MLX 後端)等框架,Meta 官方也提供了對應的量化 DFlash 草稿檔。
與 MTP 的異同
兩者都屬於「多 token 推測」的加速技術,目標都是讓一次目標模型驗證換取多個 token,且保持輸出品質。但設計哲學與實現方式有明顯差異:
| 面向 | MTP(Multi-Token Prediction) | DFlash |
|---|---|---|
| 主要階段 | 訓練時就內建(輔助目標) | 推理時的獨立草稿技術 |
| 草稿產生方式 | 模型主幹上的額外頭或序列式小模組(通常仍偏自回歸/逐步) | 獨立的輕量 block-diffusion 模型,一次平行產生整塊 token |
| 是否需要額外模型 | 否(內建於同一權重中,幾乎零額外記憶體) | 是(輕量草稿模型,通常幾百 MB 到 1–2GB) |
| 草稿成本特性 | 隨推測長度增加而上升(因為逐步生成) | 幾乎平坦(單次前向就能出整塊) |
| 接受率與加速 | 良好(常 1.5–2.5×),與模型訓練綁定 | 通常更高,實測常優於原生 MTP 與 EAGLE |
| 適用性 | 必須在預訓練/繼續訓練時就加入 MTP 目標 | 可後加在既有模型上(有對應草稿即可) |
| 品質保證 | 主頭保持原分佈 | 嚴格無損(與目標模型相同) |
| 代表例子 | DeepSeek-V3/V4、部分 Qwen、Gemma 等 | Muse Glimmer 官方草稿、Qwen 系列社群草稿等 |
簡單來說:
- MTP 是「把多步預測能力直接訓練進模型裡」,好處是整合度高、不需要第二個模型,但草稿過程通常還是相對序列化。
- DFlash 是「用擴散模型做高度平行的草稿」,把草稿階段本身從自回歸變成平行,因此在較長推測長度時優勢更明顯,實測加速往往更高。
兩者可以互補:有些模型既有原生 MTP,也可再搭配 DFlash 類型的草稿進一步提升。在 Muse Glimmer 上,Meta 選擇了 DFlash 作為官方加速方案,就是看中它在本地推理場景下的速度與接受率表現。
如果你打算在本地跑 Muse Glimmer,直接啟用官方提供的 DFlash 草稿(llama.cpp 用 --spec-type draft-dflash,或 Ollama 對應的 MLX 版本)就能獲得明顯加速。

留言
張貼留言